Слияние таблиц для новичка: JOIN

Продолжаю серию статей по работе с таблицами. На прошлой неделе уже писал о том, как работать с CONCATENATE для объединения таблиц по строкам, а в этой статье расскажу, как добавлять столбцы к уже загруженным таблицам данных с помощью JOIN.

Предыстория
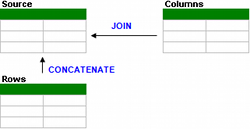
Qlikview JOIN

В прошлой статье мы рассматривали пример, в котором компания X объединяла данные по сотрудникам отдела продаж с другим офисом компании в другом регионе. Мы объединяли данные таблицы, используя CONCATENATE, рассмотрев разницу между скрытым и открытым объединением строк.

Новые требования
Qlikview JOIN

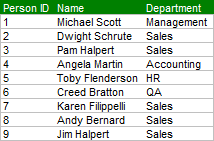
Теперь после получения единой таблицы появляются новые требования, а именно объединить данные по управлению персоналом с новой таблицей по сотрудникам так, чтобы были доступны описания функционала работы. Итак, как же это сделать?

Простая загрузка таблиц

Первый способ решения этой задачи – загрузить таблицу как есть. Получится вот такая модель данных.
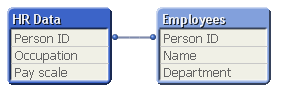
Qlikview JOIN

Технически такой способ решения не является ошибкой, ну лучше объединить представленные данные в единую таблицу, что позволит нам:

  • Упростить модель данных.
  • Опять же проще поддерживать модель данных.

JOIN

Когда добавляем JOIN до скрипта загрузки LOAD, QlikView не загружает данные в единую таблицу, а объединяет данные с предыдущей таблицей.

Qlikview JOIN

В этом случае QlikView сравнивает все общие поля в двух таблицах и объединяет строки из двух таблиц по совпадающим полям.

Дополнительно можно определить таблицы, с которыми будет идти работа по объединению данных. Если имя таблицы не определено, по умолчанию QlikView считает, что данные должны быть объединены с последней загруженной таблицей.

НА ЗАМЕТКУ! Рекомендую всегда определять имя таблицы, с которой будет вестись работа.

Типы объединений Join

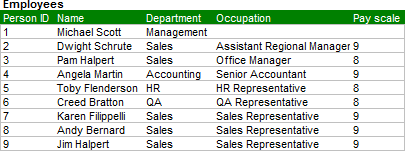
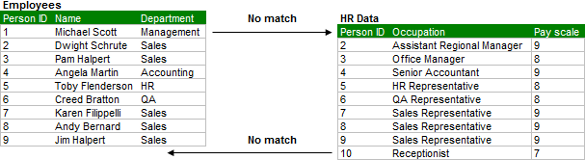
Когда вы посмотрите на наши таблицы, то увидите, что не все ID сотрудников имеют совпадения в таблицах. Таблицы Employees содержат поля сотрудник, Michael Scott, которого нет в таблице данных по управлению персоналом. А данные по управлению персоналом содержат также данные по секретарю, которого нет в другой таблице.
Qlikview JOIN

Когда мы выполняем функцию стандартного объединения, таблицы объединяются так, что связанные записи из двух таблиц отображаются в одной и той же строке. Записи без связи получаются пустыми для остальных столбцов (см. рисунок ниже):

Qlikview JOIN

Это практически та таблица, которую мы хотели получить в итоге, но здесь, по-прежнему, есть данные по секретарю, которые мы должны исключить. Эту задачу легко решить, определив тип объединения данных.

У нас есть следующие варианты объединения данных, или JOIN:

  • INNER: Только записи, которые представлены в двух таблицах входят в объединённую таблицу. В нашем случае это означает, что и первый сотрудник из таблицы 1 с ID 1 (Michael Scott) и ID 10 (секретарь) были бы исключены из итоговой таблицы.
  • OUTER: Все записи из двух таблиц будут включены в итоговую таблицу, не важно имеют они общие данные по строкам или нет. Получается такой же итог как использование обычного объединения.
  • LEFT: Все записи из первой таблицы будут включены в итоговую таблицу и только те записи из второй таблицы, которые имеют одинаковое значение с первой таблицей. В нашем примере это означает, что сотрудник ID 1 (Michael Scott) будет включен в итоговую таблицу и ID 10 (секретарь) исключен, поскольку у этой строки нет связанных данных с первой таблицей.
  • RIGHT: Все записи из второй таблицы будут включены в объединенную таблицу, а также только те строки из первой таблицы, у которых есть одинаковые записи со второй таблицей. В нашем примере это означает, что ID 10 (секретарь) будет включен в итоговую таблицу и ID 1 (Michael Scott) будет исключен.

Поскольку мы хотим иметь полную таблицу сотрудников и добавить связанные значения из данных по УП, используем LEFT JOIN.
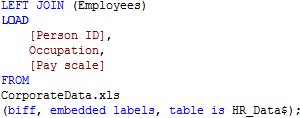
Qlikview JOIN

Получим такую таблицу:

Qlikview JOIN

взято с : http://blog.atkcg.ru/

Qlik Sense 3.0: что интересного ждать в июне?

Дорогие друзья, для вас есть прекрасная новость. На международной конференции Qlik, Qonnections 2016 (о ней мы еще напишем), был анонсирован релиз Qlik Sense 3.0 совсем скоро – в июне 2016. В сети уже есть краткое видео будущего релиза и он действительно оставляет яркое впечатление! Участники конференции увидели Qlik Sense 3.0 в работе, а я хочу вам уже сейчас рассказать, что будет всех нас ожидать в середине лета. Итаааак….

Qlik Sense 3.0: Что нового

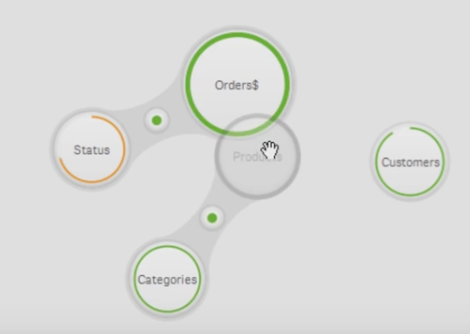
Ассоциативная модель. Связи между данными можно настраивать в режиме Drag and Drop.

Qlik Sense 3.0

Теперь разработать модель данных стало еще проще. Выстроить последовательность связей между данными можно в режиме перетаскивания объектов/таблиц в рамках модели, в которых автоматически определяется связь между массивом данных. Размер круга при этом показывает объем данных, то есть не только дизайн аналитики, но и разработка становится более визуальной! :)

Визуальный поиск

Qlik Sense 3.0

Поиск данных по ключевым словам. Например, мы хотим узнать, сколько составила чистая прибыль по месяцам, тогда пишем в строке поиска данных «net margin by month», и все данные и визуализации подтягиваются именно по этому запросу. Кроме того, в поиске можно определять тип представленной визуализации. Например, записав запрос в формате sales pie, получим данные по аналитике продаж в круговых диаграммах:

Qlik Sense 3.0

Хаб разработчика

Для разработчиков появится усовершенствованный Mashup Editor, который можно конструктировать опять же перетаскиванием нужных визуализаций из сайдбара с левой части экрана.

Qlik Sense 3.0

Усовершенствованный API

Qlik Sense 3.0

Теперь доступен упрощенный способ создания кода для визуализаций – нужный код генерируется автоматически при выборе нужного типа представления данных.

Новые источники данных

Благодаря покупке коннекторов QVSource, в Qlik Sense 3.0. расширится количество веб-источников, к которым можно подключаться напрямую, включая данные Twitter, Facebook, Google, а также облачным сервисам, таким как Microsoft Dynamics CRM и SugarCRM.

Qlik Sense 3.0

NPrinting: Pixel-perfect отчеты

Qlik Sense 3.0

Теперь функционал NPrinting будет доступен не только для QlikView, но и для Qlik Sense, включая функциональность Pixel Perfect.

Вот на этом рассказ о Qlik Sense 3.0 завершен. С нетерпением ждем июня, готовимся к новшествам Qlik и смотрим вдохновляющее видео:

Взято с : http://blog.atkcg.ru/

Что такое Hadoop?

hadoop

Hadoop – это проект с открытым исходным кодом, находящийся под управлением Apache Software Foundation (http://hadoop.apache.org/). Hadoop используется для надежных, масштабируемых и распределенных вычислений, но может также применяться и как хранилище файлов общего назначения, способное вместить петабайты данных. Многие компании используют Hadoop в исследовательских и производственных целях.


Hadoop состоит из двух ключевых компонентов:

— Распределенная файловая система Hadoop (англ. HDFS), которая отвечает за хранение данных на кластере Hadoop;

— Система MapReduce, предназначенная для вычислений и обработки больших объемов данных на кластере.


На основе этих ключевых компонентов создано несколько подпроектов, таких как Pig, Hive, HBase и т.д.

MapReduce

MapReduce – это модель программирования и каркас для написания приложений, предназначенных для высокоскоростной обработки больших объемов данных на больших параллельных кластерах вычислительных узлов:

— обеспечивает автоматическое распараллеливание и распределение задач;

— имеет встроенные механизмы сохранения устойчивости и работоспособности при сбое отдельных эелементов;

— обеспечивает чистый уровень абстракции для программистов.

HDFS

HDFS, или Распределенная файловая система Hadoop – это основная система хранения данных, используемая приложениями Hadoop. HDFS многократно копирует блоки данных и распределяет эти копии по вычислительным узлам кластера, тем самым обеспечивая высокую надежность и скорость вычислений:

— Данные распределяются по нескольким машинам во время загрузки.

— HDFS оптимизирована больше для выполнения потоковых считываний файлов, нежели для нерегулярных, произвольных считываний.

— Файлы в системе HDFS пишутся однократно и внесение никаких произвольных записей в файлы не допускается.

— Приложения могут считывать и писать файлы Распределенной файловой системы напрямую через программный интерфейс Java.


Hadoop и корпоративные системы

Hadoop-Ecosystem-Infographic-21

Системы управления реляционными базами данных (СУРБД, или англ. RDBMS) используются в системах больших компаний по стандартной схеме:

— Интерактивная система СУРБД обрабатывает запросы, поступающие с веб-сайта или других пользовательских приложений.

— Затем данные извлекаются из реляционной базы и загружаются в хранилище данных для дальнейшей обработки и архивации.

— Данные обычно денормализуются в OLAP-куб.


К сожалению, современные системы СУРБД не могут вместить все то огромное количество данных, которое создается в больших компаниях, и тогда возникает необходимость идти на компромисс: данные либо только частично копируются в СУРБД, либо удаляются через определенное время. Необходимость таких компромиссных решений отпадает, если в качестве промежуточного слоя между интерактивной базой данных и хранилищем данных используется Hadoop:

— Производительность обработки данных возрастает пропорционально увеличению объема хранилища данных, в то время как в высокопроизводительных серверах рост количества данных и изменение производительности непропорциональны.

— При использовании Hadoop, чтобы повысить производительность обработки, достаточно просто добавить новые узлы в хранилище данных.

— Hadoop может хранить и обрабатывать многие петабайты данных.


Однако Hadoop имеет ряд серьезных ограничений, и потому Hadoop не может использоваться в качестве операционной базы данных:

— Для выполнения самой быстрой задачи в Hadoop все же требуется несколько секунд.

— Не допускается внесение никаких изменений в данные, которые хранятся в системе HDFS.

— Hadoop не поддерживает транзакции.


Hadoop и СУРБД

Системы управления реляционными базами данных (СУРБД) имеют много достоинств:

— они способны оперировать сложными транзакциями;

— в них могут обрабатываться сотни тысяч запросов в секунду;

— результаты выдаются в реальном времени;

— применяется простой, но эффективный язык запросов.


Однако у СУРБД есть и слабые стороны:

— Схема данных определяется до того, как данные импортируются;

— Предельная вместимость СУРБД достигает сотен терабайтов;

— Предельное количество данных в одном запросе составляет десятки терабайтов.


Hadoop и файловые хранилища

Hadoop

Бизнес-данные больших компаний часто хранятся на больших файловых серверах типа NetApp, EMC и т.п., которые обеспечивают быстрый и произвольный доступ к данным и могут поддерживать одновременно большое количество клиентских приложений. Однако когда речь идет о хранении петабайтов данных, цена за хранение одного терабайта данных может сильно возрастать. В этом случае Hadoop представляет собой действительно удачную альтернативу файловым хранилищам, с условием, что произвольный доступ к данным возможно заменить на последовательные считывания, а изменения данных допустимо ограничить только присоединенными записями.


Hive и Pig

http://hive.apache.org/

http://pig.apache.org/


MapReduce является очень мощным инструментом обработки данных, однако он может оказаться довольно сложным для создания и поддержания, в то время как во многих компаниях работают бизнес-аналитики, которые хорошо умеют писать запросы на языке SQL, но не умеют писать код на Java. Также, во многих организациях есть программисты, умеющие писать код на скриптовых языках. Hive и Pig – это два проекта, которые разрабатывались независимо друг от друга и которые предназначены для того, чтобы помочь таким аналитикам и программистам эффективно использовать MapReduce для анализа больших массивов данных.


Hive – это надстройка над Hadoop для того, чтобы облегчить выполнение таких задач, как суммирование данных, непрограммируемые запросы и анализ больших наборов данных:


— Hive может быть использован теми, кто знает язык SQL.

— Hive создает задания MapReduce, которые исполняются на кластере Hadoop.

— Определения таблиц в Hive надстраиваются над данными в HDFS.


Pig – это платформа, предназначенная для анализа больших наборов данных и состоящая из языка высокого уровня для написания программ анализа данных и инфраструктуры для запуска этих программ. Язык характеризуется  относительно простым синтаксисом. Написанные  сценарии скрыто преобразуются в задачи MapReduce, которые исполняются на кластере Hadoop.


HBase

http://hbase.apache.org/

HBase — это колоночная база данных, расположенная поверх HDFS, которая способна вместить огромные массивы данных (от гигабайтов до петабайтов данных). HBase используется тогда, когда нужен произвольный доступ к данным, хранящимся в HDFS, в реальном времени и с правом записи и чтения.

Модель доступа к данным в HBase имеет следующие ограничения:

— поиск ряда по одному ключу;

— не поддерживаются транзакции;

— доступны только операции по одной строке.

В этом видео мы познакомимся с Cognos Architect, разберем все его компоненты такие, как приложение, кубы, измерения, репликация, процессы, работы и создадим куб на основе имеющихся измерений.

Немного поговорим об OLAP технологии для общего понимания ее сути.